Podstawy AI
Sonda AI: od automatów do chatbotów. Dlaczego tak łatwo ulegamy pozorom rozumienia?
Od mechanicznego Turka Szachisty, przez robota Elektro i psychoterapeutyczną ELIZĘ, aż po dzisiejsze modele LLM: człowiek od stuleci przypisuje maszynom świadomość i empatię tam, gdzie widzi jedynie płynne dopasowywanie wzorców. Jak odróżnić spektakl od rzeczywistej kompetencji systemu?
Fascynacja maszyną „jak żywą”
Fakty — mamy źródła.W październiku 2026 roku na antenie Radia WNET wyemitowano pierwsze trzy odcinki cyklu Sonda AI (otwiera się w nowej karcie), w których prof. Robert Trypuz podjął próbę ponownego przemyślenia korzeni cybernetyki oraz relacji człowieka z automatami. Tytuł trzeciej audycji — „Maszyny jak żywe” — celnie dotyka zjawiska towarzyszącego technologii od jej zarania: automatycznej skłonności ludzkiego umysłu do antropomorfizacji każdego układu, który wykazuje choćby pozory autonomicznego działania.Źródło: Sonda AI (WNET)
Gdy obserwujemy mechanizm lub program komputerowy odpowiadający na bodźce w sposób skoordynowany i płynny, nasza percepcja mimowolnie projektuje intencjonalność, rozumienie, a niekiedy nawet emocje. Ta iluzja nie jest jednak wynikiem zaawansowania współczesnych . Towarzyszy kulturze technicznej od setek lat, a jej mechanizmy doskonale znali dawni konstruktorzy mechanicznych spektakli.Źródła ↓
Spektakl przed inżynierią: Turek Szachista i robot Elektro
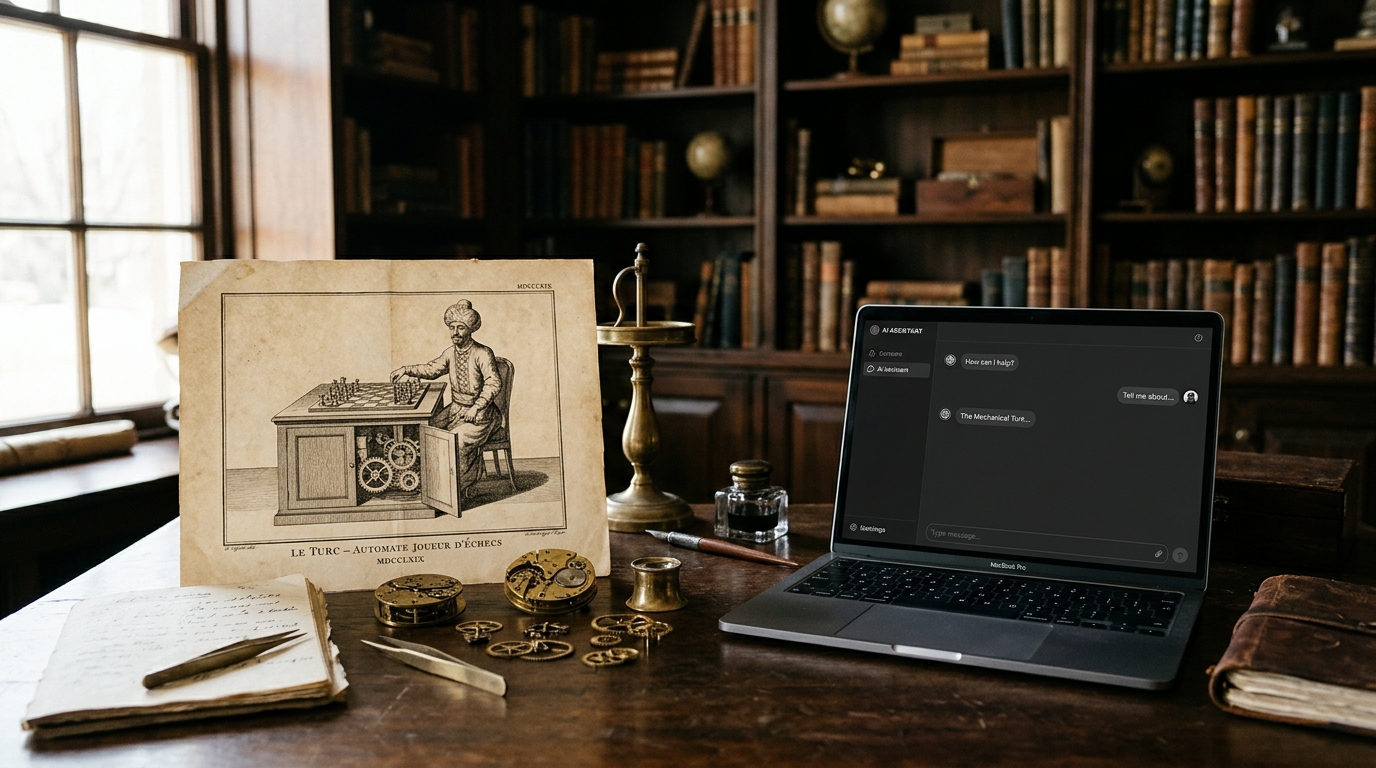
Fakty — mamy źródła.W 1770 roku radca dworu wiedeńskiego Wolfgang von Kempelen zaprezentował publiczności mechanicznego Turka Szachistę. Automat — naturalnej wielkości figura manekina w orientalnym stroju, zasiadająca przy drewnianej skrzyni pełnej kół zębatych i mosiężnych dźwigni — rozgrywał partie szachowe z arystokratami, w tym z Napoleonem Bonaparte czy Benjaminem Franklinem. Przed każdą demonstracją otwierano drzwiczki skrzyni, ukazując skomplikowaną maszynerię i zapewniając widzów o jej całkowitej autonomii. W rzeczywistości urządzenie było genialną iluzją: ruchome ścianki i system magnesów pozwalały ukryć wewnątrz żywego mistrza szachowego, który sterował ruchami manekina za pomocą pantografu.Źródła ↓
Niemal 170 lat później, podczas Wystawy Światowej w Nowym Jorku w 1939 roku, koncern Westinghouse przedstawił humanoidalnego robota Elektro. Mierzący ponad dwa metry gigant potrafił chodzić, poruszać głową i ramionami, liczyć na palcach, a nawet „palić papierosy” i wypowiadać około 700 słów. Widzowie byli zachwyceni rzekomą inteligencją maszyny. W praktyce Elektro był jednak elektromechanicznym automatem sekwencyjnym: komendy głosowe były zliczane jako impulsy akustyczne przez mikrofon, uruchamiając odpowiednie przekaźniki i odtwarzając nagrane wcześniej kwestie z 78-obrotowych płyt gramofonowych.Źródła ↓
Zarówno Turek, jak i Elektro dowodzą tej samej zasady: publiczność niemal natychmiast ulega spektaklowi technologicznemu, traktując zewnętrzną powierzchowność i płynność reakcji jako dowód wewnętrznej świadomości i rozumienia.Źródła ↓
Efekt Elizy: dlaczego szukamy serca w kodzie?
Fakty — mamy źródła.Prawdziwy przełom w badaniu psychologicznych mechanizmów antropomorfizacji przyniosły lata 60. XX wieku. W klasycznej publikacji Josepha Weizenbauma z 1966 roku (otwiera się w nowej karcie) opisany został program ELIZA, a w szczególności skrypt DOCTOR, który symulował rozmowę z psychoterapeutą nurtu rogeriańskiego. Program działał w oparciu o prosty zestaw reguł: wyszukiwał w wypowiedzi użytkownika słowa kluczowe, przekształcał zaimki i odsyłał je z powrotem w formie pytań naprowadzających (np. na słowa „Mój ojciec mnie nie lubi” odpowiadał „Dlaczego uważasz, że twój ojciec cię nie lubi?”).Źródło: Weizenbaum (1966)
Mimo że architektura ELIZY była całkowicie pozbawiona bazy wiedzy o świecie czy jakiegokolwiek modelu semantycznego, reakcje użytkowników zszokowały samego twórcę. Ludzie — w tym sekretarka Weizenbauma, która doskonale wiedziała, jak działa program — spędzali z nim godziny, zwierzając się z najgłębszych problemów osobistych i prosząc badacza o opuszczenie pokoju, by zachować prywatność rozmowy.Źródła ↓
Zjawisko to przeszło do historii informatyki i kognitywistyki jako efekt Elizy: tendencja człowieka do przypisywania programowi komputerowemu empatii, świadomości i dogłębnego rozumienia wyłącznie na podstawie powierzchownej spójności językowej. Rozumienie nie powstawało w krzemie ani w kodzie Weizenbauma — powstawało w umyśle odbiorcy, który bezwiednie wypełniał luki informacyjne własnymi emocjami i doświadczeniem.Źródła ↓
Pytanie Turinga: behawioryzm zamiast metafizyki
Fakty — mamy źródła.Zanim powstała ELIZA, fundamenty pod pragmatyczne testowanie sztucznej inteligencji położył artykuł Alana Turinga z 1950 roku (otwiera się w nowej karcie) pod tytułem „Computing Machinery and Intelligence”. Turing zaproponował w nim ucieczkę od jałowych sporów ontologicznych o to, czy maszyna „naprawdę myśli”. Zastąpił to pytanie operacyjnym eksperymentem — grą w naśladowanie (imitation game), znaną dziś powszechnie jako test Turinga.Źródło: Turing (1950)
Założenie Turinga było czysto behawioralne: jeśli sędzia prowadzący rozmowę tekstową nie jest w stanie odróżnić człowieka od maszyny, to z punktu widzenia obserwowalnego zachowania nie ma podstaw, by odmawiać systemowi inteligencji. Współczesne badania (np. eksperymenty Jonesa i Bergena z 2026 roku opisane w PNAS (otwiera się w nowej karcie), w których model .5 z odpowiednią personą był brany za człowieka w ponad 70% przypadków) pokazują, że bariera testu Turinga w krótkich oknach została w zasadzie przekroczona.Źródło: Jones & Bergen (PNAS 2026)
Sukces ten odsłonił jednak podstawowe ograniczenie behawioryzmu: test mierzy wyłącznie zdolność do zadowolenia ludzkiego arbitra i naśladowania stylu konwersacyjnego, a nie zdolność do operowania pojęciami, rozumowania przyczynowego czy posiadania ugruntowanego modelu rzeczywistości.Źródła ↓
Współczesne LLM: biegłość językowa to nie model świata
Wnioski redakcji.Współczesne (LLM) operują na niewyobrażalnie większą skalę niż ELIZA. Uczą się złożonych wielowymiarowych rozkładów statystycznych łączących na podstawie terabajtów tekstu. Dzięki temu potrafią pisać wiersze, analizować umowy prawne i generować poprawny kod w kilkunastu językach programowania.
Jednak na poziomie epistemologicznym problem pozostaje ten sam. Jak przypomina filozoficzny eksperyment Chińskiego Pokoju Johna Searle'a oraz lingwistyczny problem ugruntowania symboli (symbol grounding problem), manipulacja symbolami w oparciu o ich formę i statystyczne sąsiedztwo nie jest tożsama ze znajomością ich odniesienia do świata fizycznego. Model przewiduje najbardziej prawdopodobny następny token — nie posiada intencji, nie odczuwa odpowiedzialności i nie „wie”, o czym pisze w ludzkim znaczeniu tego słowa.
Efekt Elizy działa dziś ze zdwojoną siłą, ponieważ współczesny nie posługuje się prostymi szablonami, lecz elokwentną, nienaganną polszczyzną czy angielszczyzną. Gdy model odpowiada z emfazą i uprzejmością, bezwiednie zakładamy, że stoi za tym podmiot rozumiejący sytuację. Tymczasem jest to wciąż zaawansowany proces statystycznej aproksymacji.
Cztery pytania przed wdrożeniem AI zamiast bezkrytycznego zachwytu
Wnioski redakcji.Brak ludzkiego rozumienia nie oznacza, że systemy AI są bezużyteczne. Przeciwnie: w ściśle określonych zadaniach transformacji tekstu, wyszukiwania informacji w dokumentach czy asysty programistycznej ich wydajność inżynieryjna jest rewolucyjna. Aby jednak uniknąć kosztownych rozczarowań i , każdy zespół wdrażający AI powinien zastąpić zachwyt czterema pytaniami kontrolnymi:
1. Konkretność zadania: Co dokładnie wykonuje model? Czy oczekujemy od niego precyzyjnej ekstrakcji danych z dostarczonego (gdzie sprawdza się znakomicie), czy otwartego doradztwa w warunkach niepewności (gdzie ryzyko konfabulacji jest krytyczne)?
2. Czystość benchmarku i danych: Czy imponujący wynik modelu nie wynika z faktu, że dane testowe wyciekły do zbioru treningowego (data contamination)? Weryfikujmy działanie na własnych, unikalnych przykładach z wewnętrznej domeny.
3. Odporność na perturbacje: Jak model zachowuje się przy zmianie kolejności założeń, odwróceniu pytania lub podaniu niepełnych informacji? Prawdziwa kompetencja techniczna broni się w warunkach brzegowych, iluzja sypie się przy drobnej zmianie kontekstu.
4. Zewnętrzna pętla weryfikacji: Gdzie w procesie znajduje się człowiek lub deterministyczny sprawdzający fakty? Model nie może być jedynym i ostatecznym sędzią własnych wniosków.
Historia od Turka Szachisty po generatywne chatboty uczy nas jednego: technologia może stworzyć doskonałą iluzję porozumienia. Zadaniem inżyniera, edukatora i menedżera jest pamiętać, gdzie kończy się spektakl, a zaczyna rzetelna weryfikacja.
Aktywny warsztat czytelnika
Pod każdą sekcją tego artykułu możesz dopisać własne notatki robocze (wnioski, pytania do zespołu). Zapisują się automatycznie w pamięci Twojej przeglądarki (100% lokalnie) i możesz je w każdej chwili wyeksportować jako plik Markdown (.md) do Obsidiana lub Second Brain.
Źródła i dalsza lektura
- 1.
- 2.
- 3.
- 4.
Powiązane materiały
Jak działają duże modele językowe i multimodalne
Tokeny, okno kontekstu, trening i dostrajanie. Wyjaśniamy, co dzieje się między Twoim pytaniem a odpowiedzią modelu.
Promptowanie i weryfikacja wyników: metoda pięciu kroków
Dobry prompt to jasny cel, kontekst, format i kryteria. Dobra praca z AI to także sprawdzenie, czy wynik jest prawdziwy i użyteczny.
Uprzejmość wobec chatbotów AI: norma społeczna a skuteczność promptu
Dlaczego mówimy „proszę” i „dziękuję” maszynom? Analiza badań nad psychologią interakcji człowiek–AI oraz wpływem tonu na jakość odpowiedzi modeli.