Agenty AI
Od second brain do zespołu agentów AI. LLM jako PM w praktyce
i w , w przeglądarce, Sejf oparty na i oraz projekty na i . Pokazujemy, jak te elementy łączą się w sprawdzalny proces pracy — na prawdziwych przykładach, bez przypisywania agentom niepotwierdzonej autonomii.
1. Mój warsztat pracy: kilka narzędzi, wspólne repozytoria
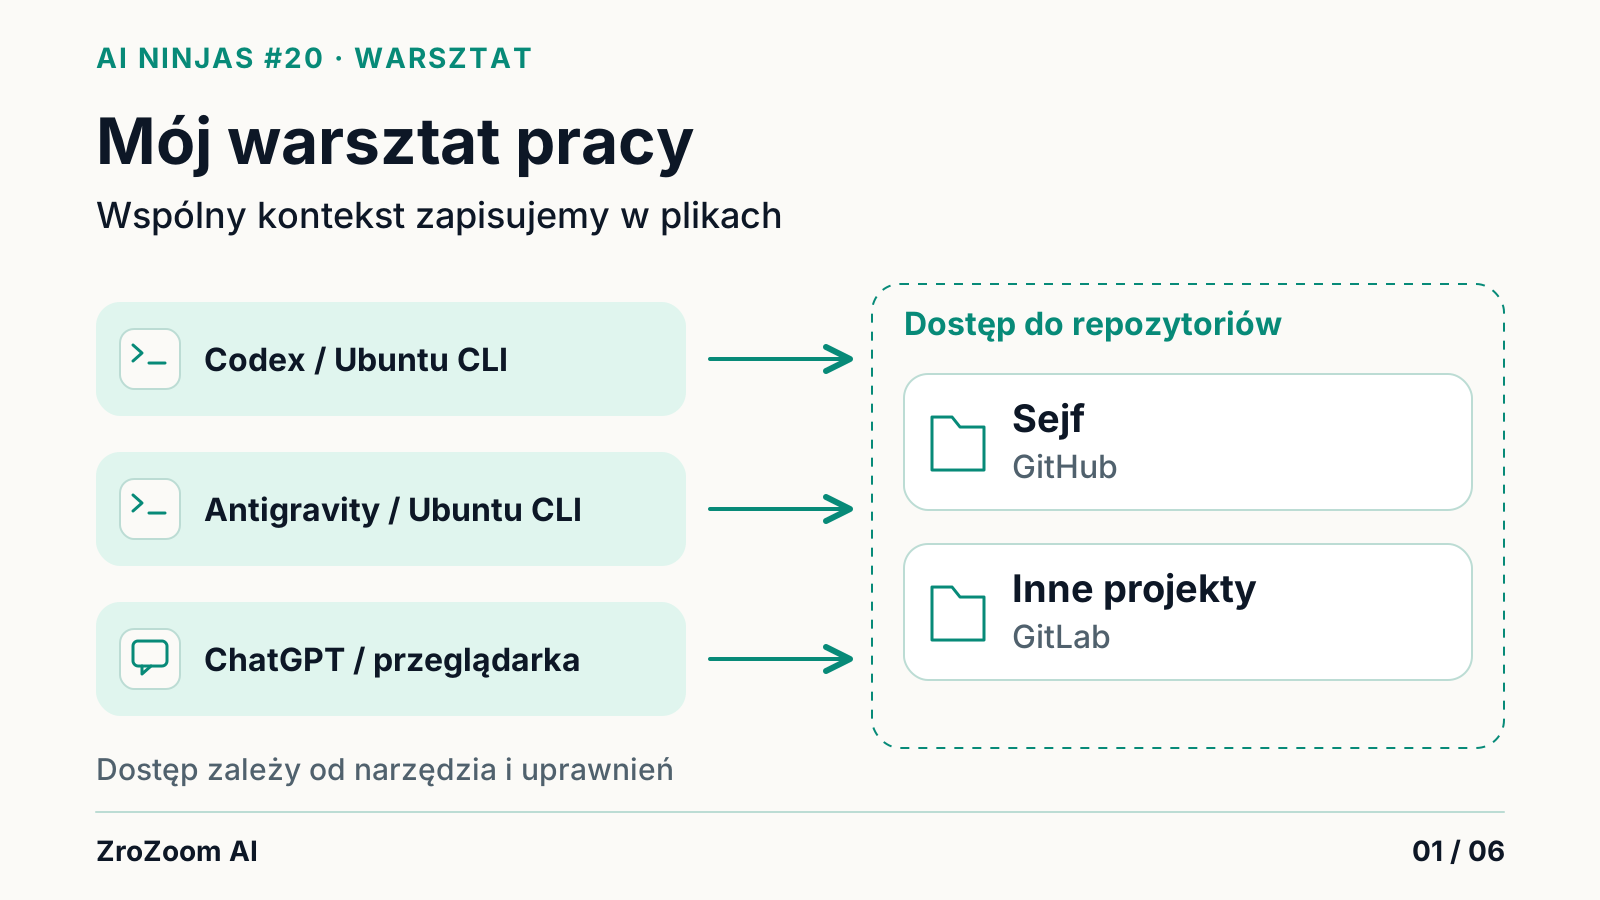
Fakty — mamy źródła.W codziennej pracy z projektami informatycznymi i edukacyjnymi korzystam z trzech głównych środowisk. Codex i Antigravity uruchamiam w terminalu . ChatGPT wykorzystuję w przeglądarce. Wszystkie te narzędzia mogą — w zakresie przyznanych im dostępów — pracować z odpowiednimi repozytoriami. Część projektów prowadzę na GitHubie, inne na GitLabie.Źródła ↓
To nie są trzy okna jednej aplikacji ani trzy modele, które automatycznie pamiętają nawzajem swoje rozmowy. Narzędzie terminalowe może pracować na lokalnej kopii repozytorium; ChatGPT w przeglądarce może korzystać z udostępnionych integracji. Ich konfiguracje, uprawnienia i dostęp do mogą być różne. Wspólny punkt odniesienia stanowią zapisane pliki, zgłoszenia, commity i historia zmian.Źródła ↓
W praktyce zaczynam od problemu: treść wymaga sprawdzenia, funkcja nie działa, dokumentacja stała się nieaktualna albo trzeba zaplanować nowe zadanie. Model może pomóc rozeznać kontekst i zaproponować plan, ale rezultat powinien być widoczny poza samą rozmową — w dokumencie, raporcie, teście lub różnicy między wersjami plików.Źródła ↓
Takie podejście pozwala mi przechodzić między narzędziami bez konieczności traktowania którejkolwiek sesji jako jedynej pamięci projektu. Jest to jednak sposób organizacji pracy, a nie dowód na automatyczną synchronizację całej wiedzy między .Źródła ↓
2. Sejf: Obsidian, OKF i Git zamiast pamiętania wszystkiego w czacie
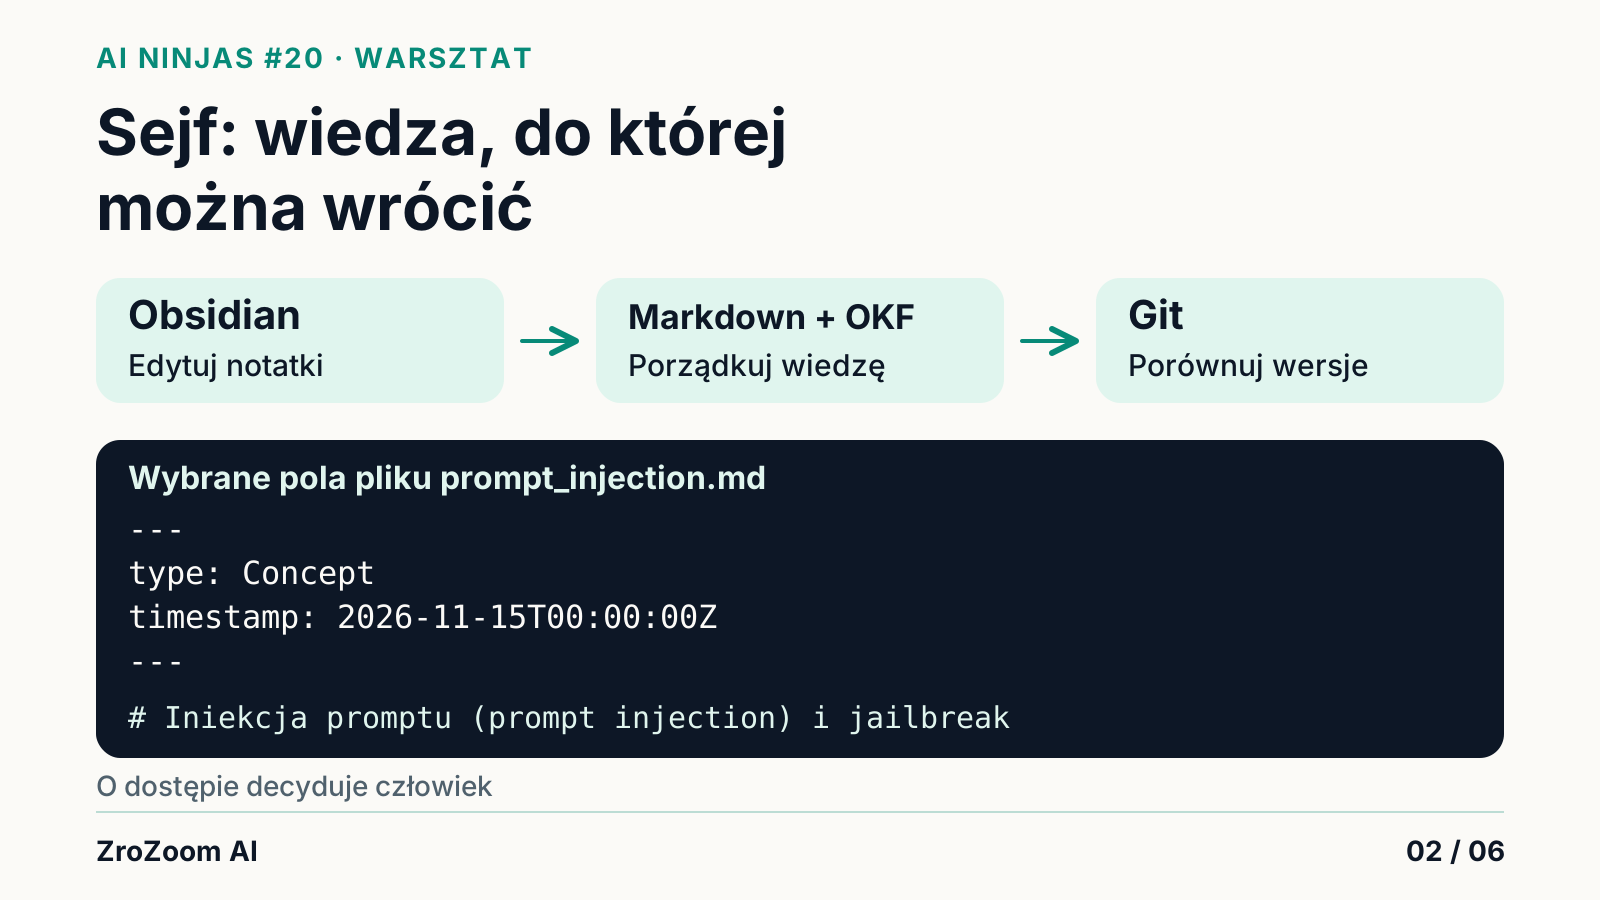
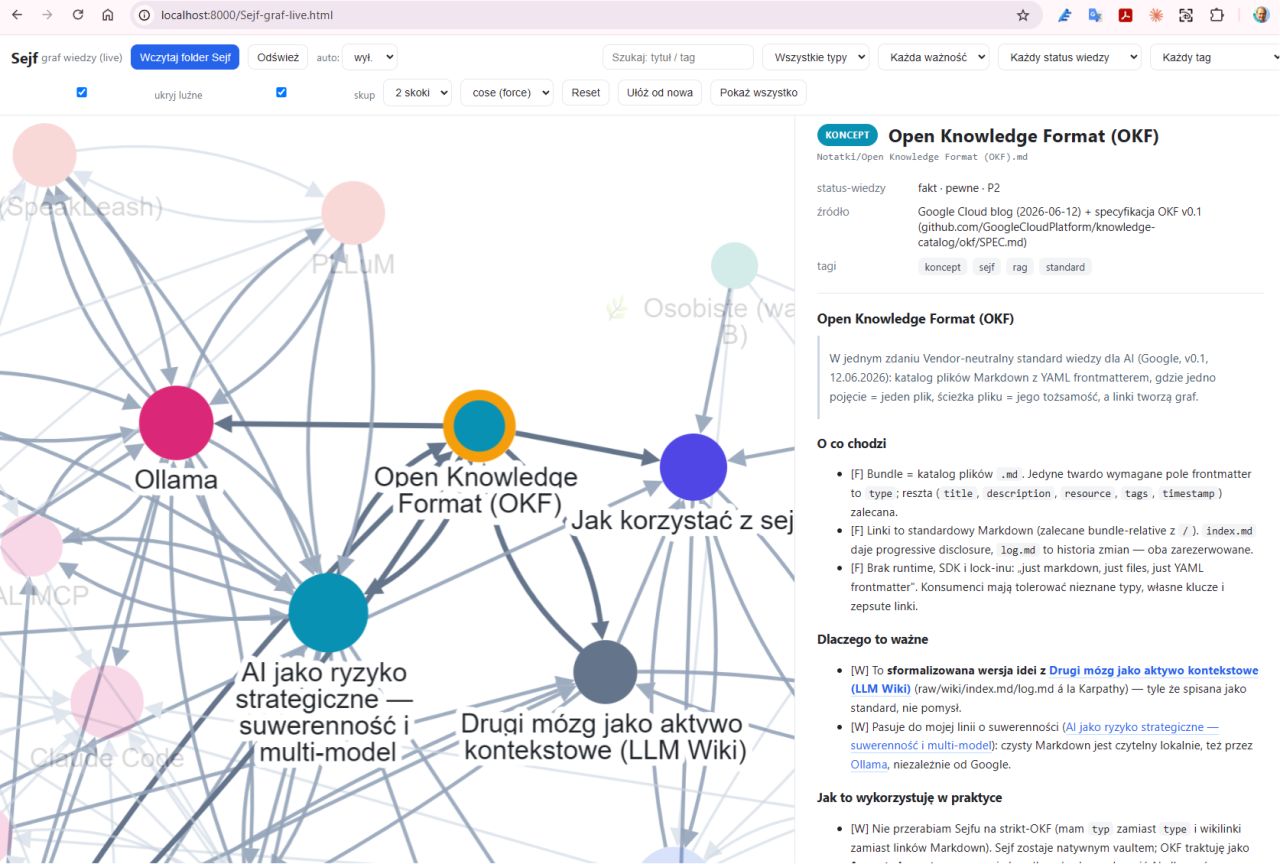
Fakty — mamy źródła.Nasz nazywa się Sejf. Jego podstawą są notatki i powiązania, z którymi wygodnie pracuje się w Obsidianie. Sejf umieściliśmy w repozytorium GitHub, aby uprawnione narzędzia AI mogły odczytywać kontekst, a zmiany dawało się porównywać, recenzować i odtwarzać. nie zastępuje Obsidiana: rozwiązuje inny problem — wersjonowanie i współpracę nad plikami.Źródła ↓
Drugim elementem jest OKF (Open Knowledge Format). Specyfikacja OKF (otwiera się w nowej karcie) opisuje przenośną strukturę wiedzy opartą na Markdown i metadanych YAML, z konwencjami indeksów, źródeł oraz powiązań. Nasz sposób stosowania OKF ma własne reguły: jedno kanoniczne miejsce dla danej definicji (Single Source of Truth), rozróżnienie faktów, wniosków i hipotez oraz opisane procedury aktualizacji i recenzji. To rozszerzenia ZroZoom AI, a nie obowiązki narzucone wszystkim użytkownikom formatu.Źródło: OKF — specyfikacja
Jak wygląda zapis? Weźmy istniejący plik „_injection.md”: na początku ma metadane YAML między liniami „---”, m.in. typ Concept, tytuł, opis, odnośnik do źródła NIST, tagi i datę. Poniżej jest treść Markdown: nagłówki, definicja, wyjaśnienie i bibliografia. Znacznik „^definicja” wskazuje w naszych konwencjach blok kanoniczny. To zwykły plik tekstowy, czytelny poza jedną aplikacją.Źródła ↓
W Sejfie współistnieją notatki Obsidiana i uporządkowany pakiet danych OKF. Notatki mają linki do innych notatek, mapy treści i własne pola, np. status wiedzy, pewność, źródło czy zastosowanie. W pakiecie OKF podstawową metadaną konceptu jest „type”; indeks i historia zmian pomagają w nawigacji. Nie zakładamy, że każda starsza notatka już spełnia specyfikację OKF.Źródła ↓
Istotna uwaga o wersjach: opisujemy możliwości standardu upstream OKF .2, ale indeks Sejfu nadal deklaruje wersję 0.1. Migracja jest etapowa; nie przedstawiamy całej bazy jako w pełni przeniesionej do v0.2.Źródła ↓
W Sejfie znajdują się notatki źródłowe, standardy, decyzje i audyty. Gdy agent pracuje nad artykułem, nie wystarczy powiedzieć mu: 'napisz coś o AI'. Może najpierw sprawdzić, co już ustaliliśmy, jakie źródła wykorzystaliśmy, co zostało zweryfikowane, a gdzie pozostały pytania. W dobrze prowadzonym procesie aktualizujemy istniejącą wiedzę zamiast bez potrzeby tworzyć jej kolejne kopie.Źródła ↓
Przechowywanie notatek w repozytorium nie daje jednak każdemu modelowi nieograniczonego dostępu. Kontrola uprawnień nadal ma znaczenie. Podobnie sam projekt integracji OKF z bazą danych Supabase nie dowodzi, że wszystkie przewidziane mechanizmy synchronizacji, zatwierdzania i publikacji już działają.Źródła ↓
---
type: Concept
title: "Iniekcja promptu (prompt injection) i jailbreak"
resource: https://doi.org/10.6028/NIST.AI.100-2e2025
tags: [ai, bezpieczeństwo, llm, prompt-injection, jailbreak, adversarial-ml, genai]
timestamp: 2026-11-15T00:00:00Z
---

# Iniekcja promptu (prompt injection) i jailbreak

## Definicja kanoniczna
… ^definicja
Fragment rzeczywistego pliku z repozytorium Sejfu. Pominięto opis i pełną definicję (…); ^definicja oznacza lokalną kotwicę bloku kanonicznego. Nie jest to deklaracja pełnej zgodności całego Sejfu z OKF v0.2.
3. To już nie jest zwykły czat: jedna sesja, wiele kroków
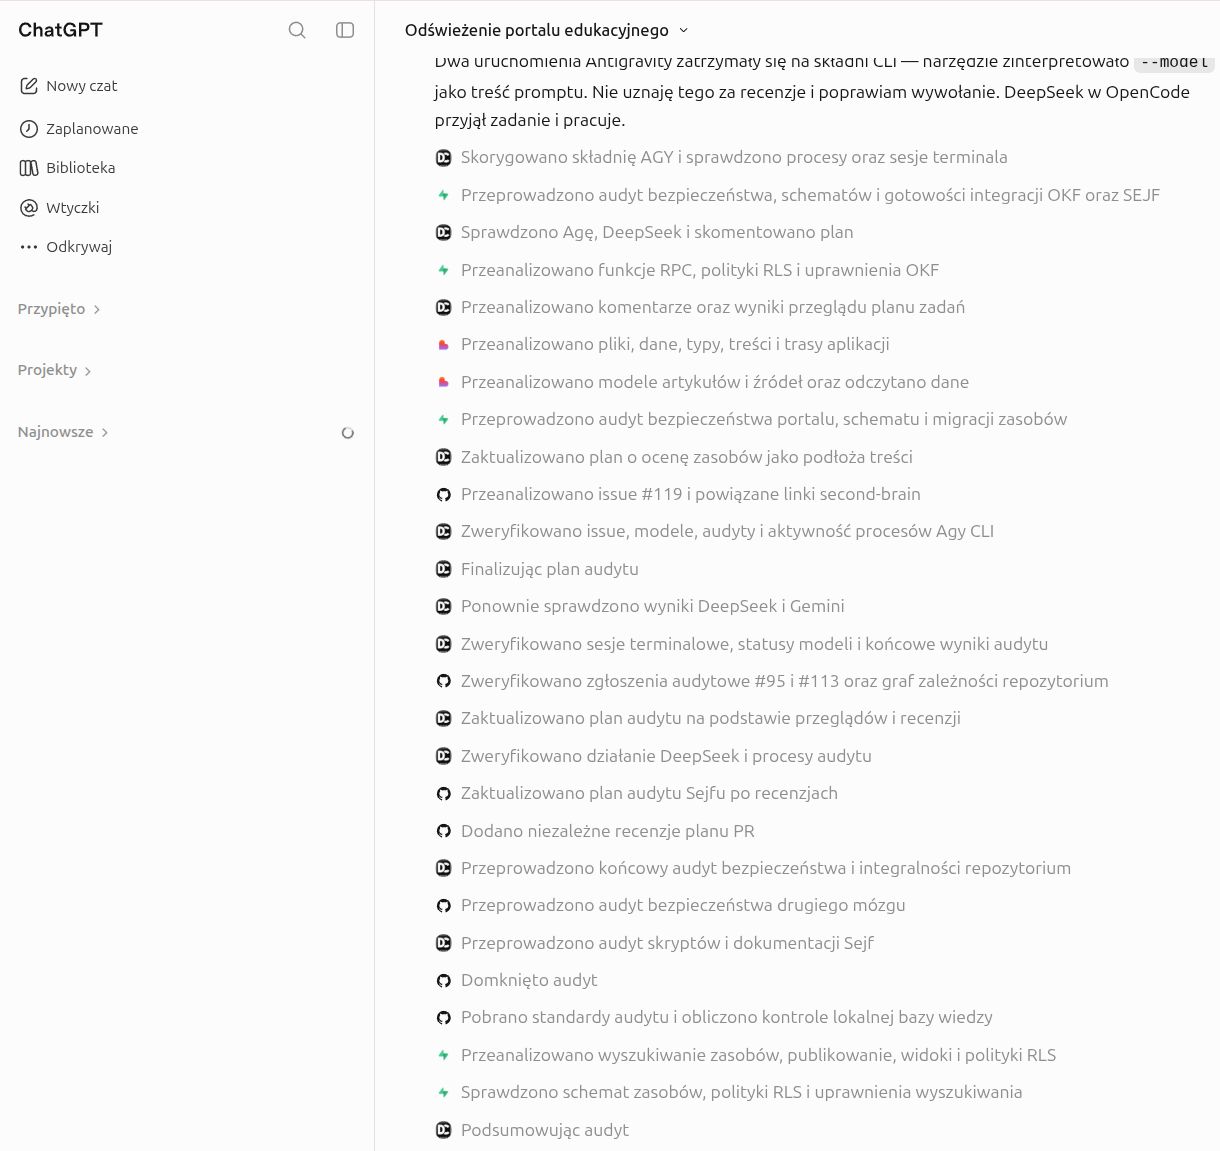
Fakty — mamy źródła.W relacji przygotowanej na warsztat opisuję fragment sesji ChatGPT zatytułowanej „Odświeżenie portalu edukacyjnego”. Przedstawia wieloetapowy przebieg: analizę plików, danych, modeli i tras aplikacji, audyt bezpieczeństwa oraz uprawnień, sprawdzanie zgłoszeń i zależności, poprawianie planu, ponowne kontrole i domykanie audytu. Opis tych kroków jest punktem wyjścia do sprawdzenia wyników.Źródła ↓
W tej pracy używam ChatGPT w procesie obejmującym także narzędzia terminalowe, GitHub, Supabase i . Zależnie od zadania korzystam również z innych modeli do konsultacji i recenzji. Ich udział trzeba potwierdzić w konkretnym przebiegu pracy; sama lista dostępnych narzędzi nie świadczy o tym, że wszystkie pracowały równolegle.Źródła ↓
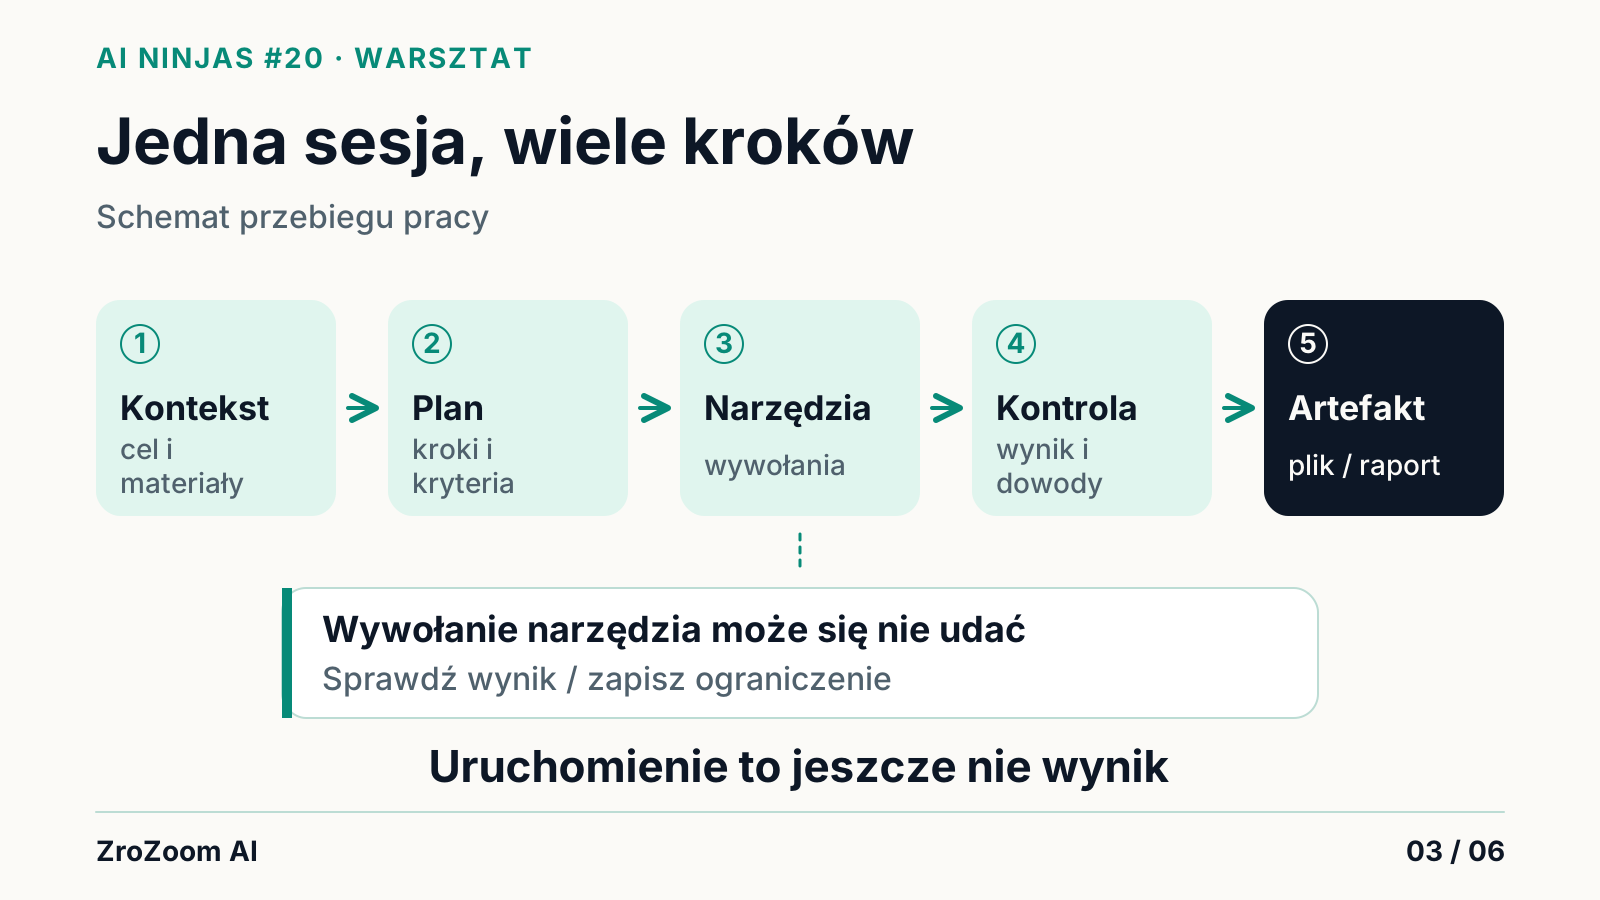
W relacji z sesji odnotowano problem ze składnią wywołania narzędzia . Takie zdarzenie wymaga rozpoznania błędu i sprawdzenia, czy w ogóle powstał wynik recenzji. To praktyczna zasada: status „uruchomiono” nie znaczy „wykonano”, a komunikat „sprawdzono” wymaga potwierdzenia artefaktem.Źródła ↓
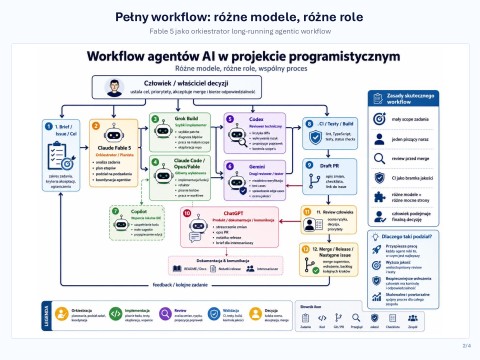
Diagram podziału pracy między różne role pomaga omówić planowanie, wykonanie, recenzję i wydanie. W tym materiale pokazujemy schematy, które nie ujawniają prywatnych ekranów. Każdą ścieżkę diagramu trzeba odróżnić od czynności rzeczywiście potwierdzonej w danym zadaniu.Źródła ↓
Fragment sesji i relacja autora mogą zilustrować sekwencję pracy, lecz nie zastępują wynikowych plików, logów i raportów. Nie traktujemy ich jako niezależnego potwierdzenia poprawności całego audytu ani udziału konkretnego modelu w każdej recenzji.Źródła ↓
4. LLM jako Project Manager: od zgłoszenia do rezultatów
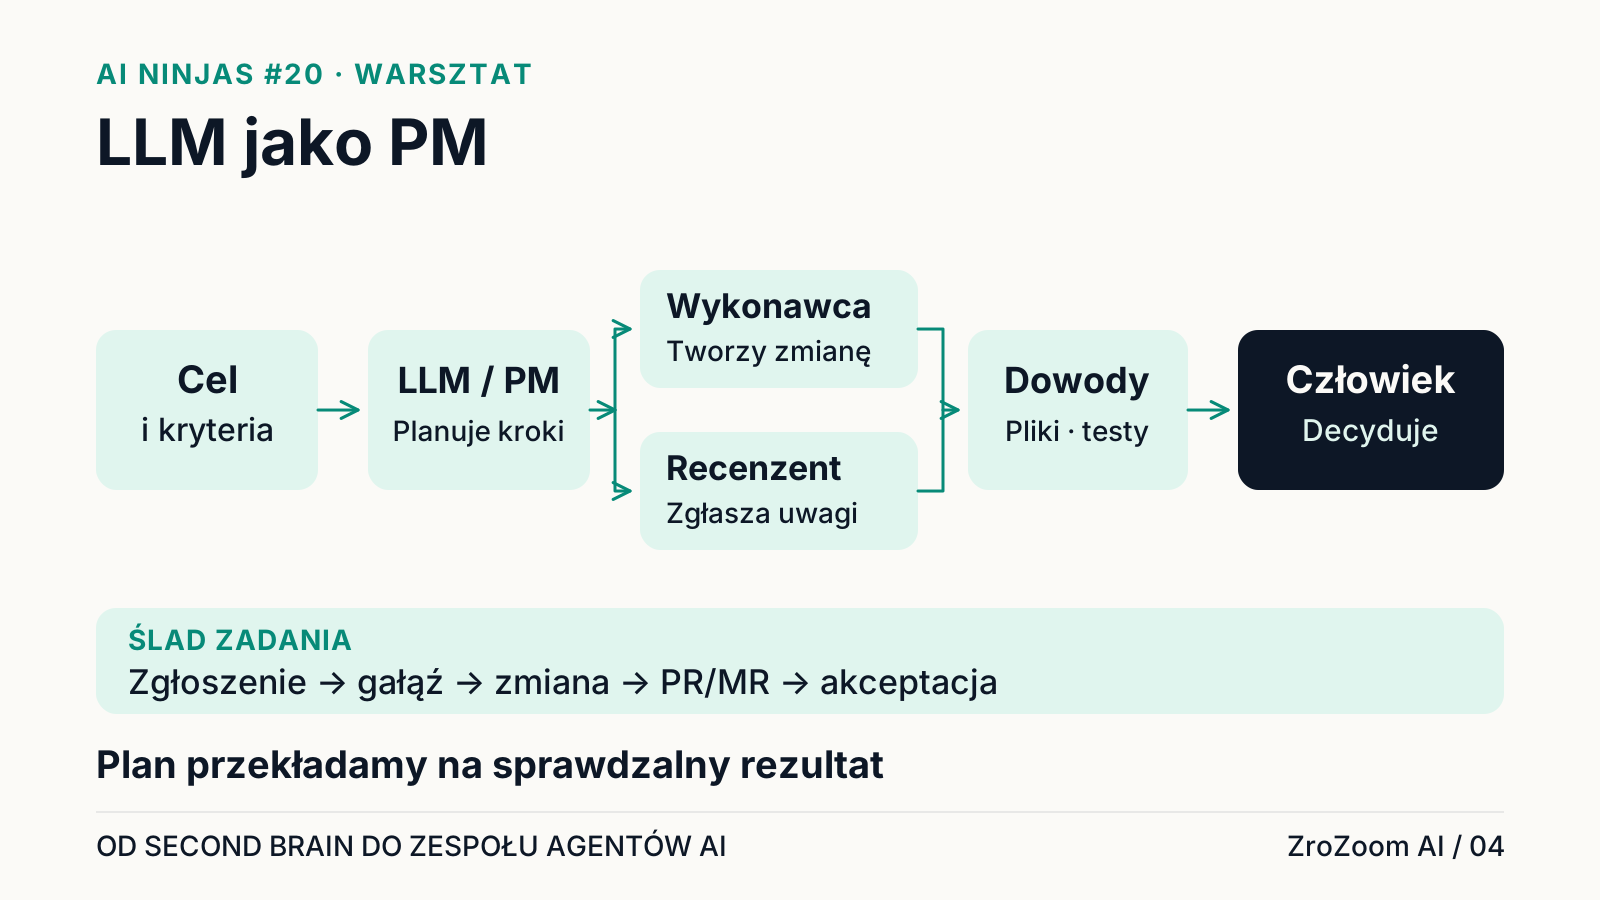
Wnioski redakcji.Nie chodzi o to, by nadać modelowi stanowisko kierownicze. Praktyczna rola PM polega tu na rozpoznaniu celu, odnalezieniu kontekstu, podziale zadania na mniejsze części, wskazaniu zależności, dobraniu wykonawcy i przygotowaniu kryteriów odbioru. Część tych działań można wykonać w jednej sesji ChatGPT, a część przekazać narzędziom pracującym w repozytorium.
W projekcie zrozoom-ops istnieją opisujące takie role. Trzeba jednak czytać ich rzeczywisty zakres: obecny skill 'product-manager' skupia się przede wszystkim na koordynacji dostarczania zmian, testach i gotowości wydania. Skill 'delegate' przygotowuje polecenie wykonawcze na podstawie istniejącego issue. Sam opis skilla nie stanowi dowodu, że zadanie zostało przydzielone, odebrane i zakończone.
Konkretny ślad pracy mamy w Sejfie. W jednym z zakończonych zadań uporządkowaliśmy cztery kanoniczne pojęcia: , , i . W historii repozytorium są zmienione pliki, lista zmian, kolejne wersje commitów oraz zapisane recenzje. Zmiana została scalona. Rezultat można więc otworzyć i porównać z wymaganiami.
Ten przykład nie potwierdza samodzielnie działania autonomicznej floty. W historii widoczne są powtarzane recenzje Codexa na różnych commitach. Ich liczby nie utożsamiamy z niezależnymi ocenami różnych modeli: do takiego twierdzenia potrzeba zapisu, kto sprawdził konkretną wersję i z jakim wynikiem.
Dokumentacja GitHub (otwiera się w nowej karcie) rozróżnia wersję roboczą Pull Requestu od zmiany gotowej do przeglądu. W Sejfie zmiany AI przechodzą przez osobną gałąź, PR, udokumentowane recenzje na aktualnej wersji i osobną decyzję właściciela przed scaleniem. Gotowość do przeglądu oraz zgoda na merge to dwa różne etapy.
5. Różne modele mogą pełnić różne role, ale recenzja nie zastąpi dowodu
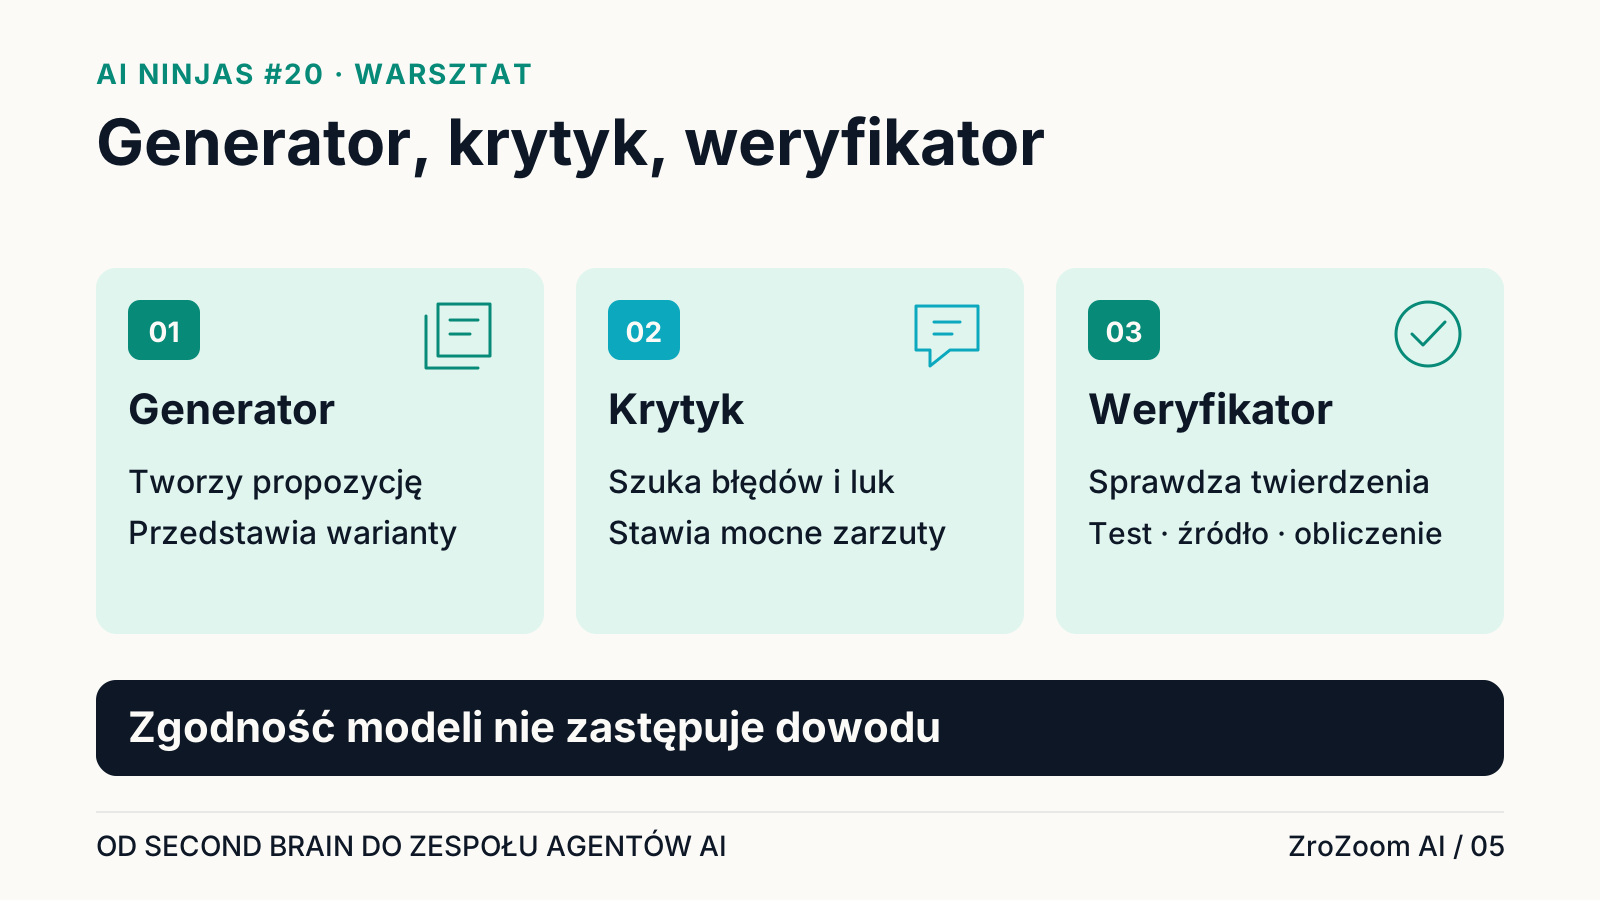
Wnioski redakcji.W pracy z AI rozdzielam trzy funkcje. Generator przygotowuje propozycję. Krytyk szuka błędów, luk i kontrargumentów. Weryfikator porównuje konkretne twierdzenia z testami, danymi, obliczeniami lub źródłami. To role w procesie — nie obowiązek uruchamiania trzech osobnych modeli. Gdy potrzebna jest niezależna recenzja, ważna jest rzeczywista niezależność oceny, a nie tylko inna nazwa okna.
Badanie Stechly, Valmeekam i Kambhampati (otwiera się w nowej karcie), opublikowane na ICLR 2025, dotyczyło -0613 w formalnych zadaniach rozumowania i planowania. Samokrytyka pogorszyła wynik w trzech z czterech wariantów zadań; w czwartym wynik się poprawił. Korzyści dawał poprawny zewnętrzny weryfikator dopasowany do zadania — mechanizm sprawdzający reguły, nie drugi model językowy. Wyniki tego eksperymentu nie rozstrzygają skuteczności wszystkich recenzji AI.
Jeżeli poprawność programu można sprawdzić testem, uruchamiamy test. Jeżeli artykuł zawiera dane, szukamy odpowiedniego źródła pierwotnego. Jeśli dwaj recenzenci różnią się oceną, analizujemy konkretne zarzuty. Głosowanie modeli nie zastępuje dowodu.
Anthropic rozróżnia (otwiera się w nowej karcie) uporządkowane przepływy pracy od agentów, które samodzielniej dobierają kroki i narzędzia. Wskazuje również, że dodatkowa złożoność, koszt i czas są uzasadnione dopiero wtedy, gdy rozwiązanie rzeczywiście daje korzyść. Właśnie dlatego często wystarcza jeden dobrze określony proces zamiast mnożenia agentów.
6. Co mamy wdrożone, a czego nie należy dopowiadać?
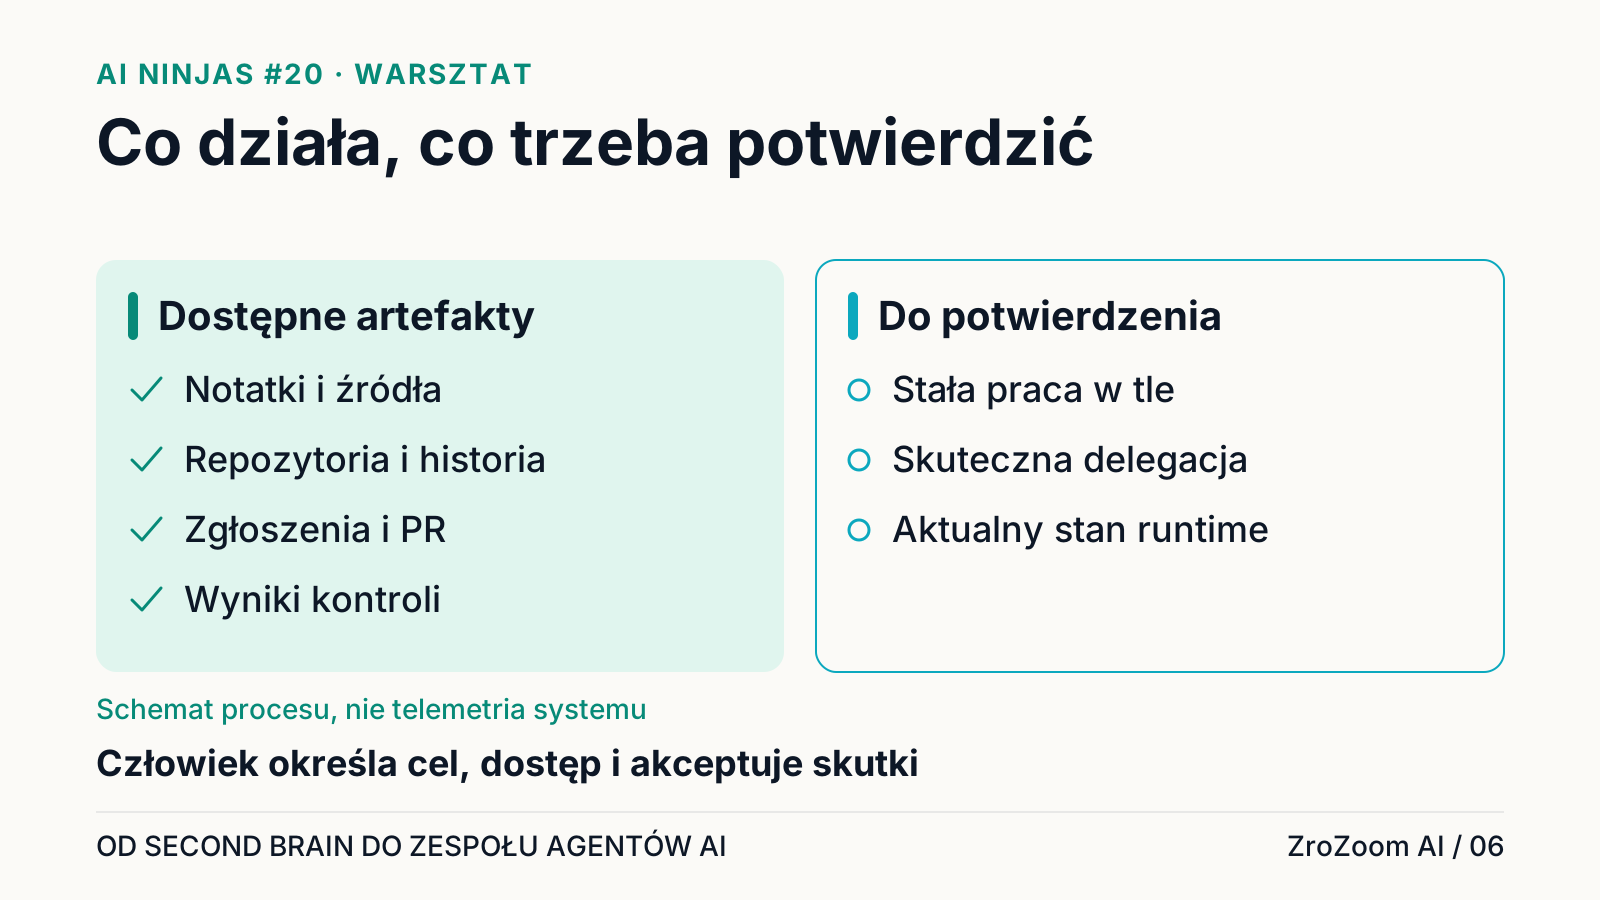
Wnioski redakcji.Możemy pokazać realnie istniejące elementy warsztatu: Sejf i jego pliki, repozytoria GitHub i GitLab, pracę w terminalu i przeglądarce, zgłoszenia, commity, PR-y, zapisane komentarze recenzentów i konkretne rezultaty zmian. Możemy też pokazać błędy wywołania narzędzi oraz sytuacje, w których potrzeba kolejnej kontroli. To wystarczająco dużo na merytoryczną prezentację.
Nie powinniśmy jednocześnie utożsamiać zaprojektowanego systemu z działającą instalacją. W audycie Fleet z 1 listopada 2026 r. potwierdzono kod, fragmenty testów i wcześniejsze ślady pracy, ale nie zebrano dostatecznych dowodów aktualnego działania całego systemu agent dispatch. Ten wynik dotyczy dnia i zakresu audytu. Nie przesądza o późniejszym stanie całej infrastruktury.
Podobnie schemat z wieloma modelami, rolami i etapem release jest przydatną mapą procesu, lecz sam rysunek nie potwierdza aktywności każdego wskazanego ogniwa. Zrzut z sesji ChatGPT może zilustrować sekwencję pracy i użycie narzędzi, ale jego podpis nie powinien sugerować certyfikowanego audytu ani pełnego nadzoru nad wszystkimi systemami.
Najważniejsza zasada mojej pracy brzmi: projektuj, deleguj i weryfikuj. Agent może przygotować plan, napisać kod, porównać źródła i wskazać błąd. Człowiek musi określić sens zadania, nadać właściwe uprawnienia, sprawdzić skutki oraz zdecydować o publikacji, wdrożeniu i innych działaniach, których nie da się łatwo cofnąć.
O wartości zespołu agentów nie świadczy liczba modeli na diagramie. Świadczy o niej to, czy po zakończeniu pracy potrafimy wskazać źródła, artefakty, decyzje i wynik, za który ktoś bierze odpowiedzialność.
Źródła i dalsza lektura
- 1.OKF v0.2 — SPEC.md (kanoniczna specyfikacja formatu) GoogleCloudPlatform / GitHub
- 2.About pull requests — dokumentacja GitHub GitHub Docs
- 3.
- 4.
- 5.Sejf — własna dokumentacja OKF/SSOT, workflow zmian, zweryfikowana historia zadań i datowany audyt runtimeZroZoom AI, wewnętrzne repozytorium
- 6.Relacja autora o sesji „Odświeżenie portalu edukacyjnego” i podziale ról; materiał warsztatowy z 19.11.2026, bez niezależnej weryfikacji prywatnych zrzutówZroZoom AI, materiały prowadzącego
Powiązane materiały
Agenty AI: kiedy model zaczyna działać, a nie tylko odpowiadać
Agent łączy model językowy z narzędziami, planowaniem kroków i pętlą wykonawczą. Omawiamy wzorce architektoniczne, granice autonomii i zasady bezpieczeństwa.
Promptowanie i weryfikacja wyników: metoda pięciu kroków
Dobry prompt to jasny cel, kontekst, format i kryteria jakości. Omawiamy profesjonalną inżynierię poleceń, oficjalne wytyczne twórców modeli oraz procedurę audytu odpowiedzi według ramy NIST.
Automatyzacja pracy z AI: od powtarzalnego zadania do przepływu
Jak wybrać proces do automatyzacji, gdzie wstawić model językowy, a gdzie zachować tradycyjny kod i decyzję człowieka. Praktyczny przewodnik po architekturze przepływów i wymogach RODO.
Mapa narzędzi AI: jak wybierać, zamiast kolekcjonować
Kategorie narzędzi zamiast rankingów, które starzeją się w miesiąc. Asystenci rozmowy, wyszukiwanie badawcze, analiza dokumentów, programowanie i automatyzacja — jak dobrać właściwy instrument do zadania.