Modele językowe i multimodalne
Modele rozumujące AI w 2026: kiedy pomagają, jak je sprawdzać i czego nie dowodzą
Tryby thinking i modele rozumujące pomagają w zadaniach wieloetapowych, ale nie gwarantują poprawności. Wyjaśniamy ich praktyczne zastosowania, koszty i metody sprawdzania wyników.
Rozszerzenie artykułu Grzegorza Łukasika z 2025 r.
Opracowanie redakcji ZroZoom AI z 18 listopada 2026 r. rozwija temat tekstu „Czym są modele rozumujące i jak z nich korzystać?” Grzegorza Łukasika (16 kwietnia 2025). Oryginał pozostaje w archiwum Bloggera oraz w archiwum portalu; nie zastępujemy jego autorstwa ani daty.
Co oznacza „model rozumujący”?
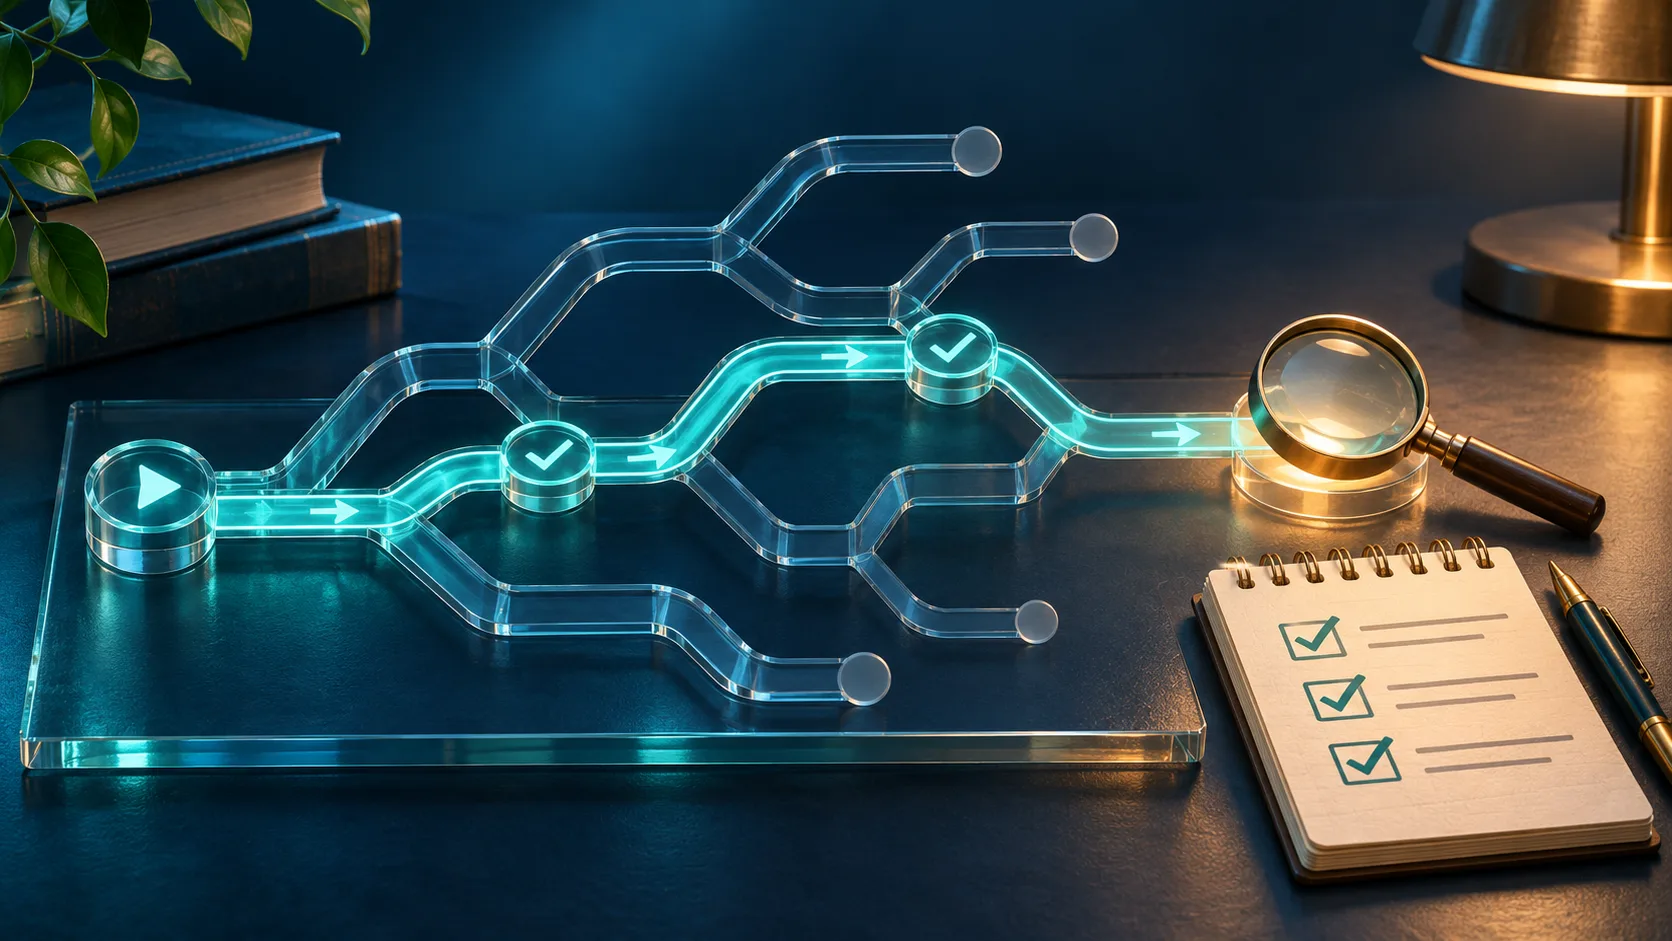
Fakty — mamy źródła.Dokumentacja OpenAI o rozumowaniu (otwiera się w nowej karcie) opisuje modele, które mogą przeznaczać dodatkowe zasoby obliczeniowe na opracowanie odpowiedzi przed jej przedstawieniem. Takie podejście bywa użyteczne przy programowaniu, matematyce i analizie problemów z wieloma ograniczeniami. Określenie „thinking” jest nazwą funkcji lub sposobu pracy modelu, nie dowodem ludzkiej świadomości.Źródło: OpenAI — reasoning
Dokumentacja Gemini Thinking (otwiera się w nowej karcie) przedstawia podobną ideę: model dostosowuje wysiłek wnioskowania do złożoności zadania. Dostawcy stosują własne parametry i formaty wyjścia, więc „wysoki poziom myślenia” nie stanowi wspólnej, porównywalnej jednostki jakości.Źródło: Google — Gemini Thinking
Kiedy dodatkowe rozumowanie pomaga?
Wnioski redakcji.Warto spróbować: wieloetapowe zadanie matematyczne, przegląd zmian w kodzie, porównanie ofert z jawnymi kryteriami, plan projektu ze sprzecznymi wymaganiami, znalezienie niespójności w tabeli danych.
Niekoniecznie warto: proste tłumaczenie, formatowanie tekstu, sprawdzenie daty ze znanego źródła, krótka klasyfikacja lub zadanie, w którym ważniejsza jest szybkość. Dobór trybu uzależnij od kosztu, czasu odpowiedzi i ryzyka pomyłki.
Jak pisać polecenia i oceniać odpowiedzi
Fakty — mamy źródła.Przewodnik OpenAI po dobrych praktykach (otwiera się w nowej karcie) zaleca proste i jednoznaczne polecenia. Wielokrotne instruowanie modelu „myśl krok po kroku” nie zawsze poprawia wynik i bywa zbędne; ważniejsze jest opisanie celu, danych, ograniczeń oraz formatu rezultatu.Źródło: OpenAI — dobre praktyki
Przykład: „Rozwiąż zadanie z geometrii dla ucznia liceum. Podaj wynik, uzasadnienie matematyczne, a na końcu sprawdź rozwiązanie przez podstawienie. Jeśli brakuje danych, wskaż je zamiast zgadywać”. Uzasadnienie wygenerowane w odpowiedzi nie jest gwarantowanym zapisem całego procesu wewnętrznego modelu.Źródła ↓
Weryfikacja jest ważniejsza od efektownego wywodu
Wnioski redakcji.Przy obliczeniach sprawdź wzory i wynik niezależnym narzędziem (np. kalkulatorem, Pythonem lub GeoGebrą). Przy kodzie uruchom testy i przejrzyj zmiany; przy prawie, zdrowiu i finansach sięgnij do dokumentów źródłowych i specjalistycznej oceny.
Długi, pewnie brzmiący opis nie dowodzi prawdziwości odpowiedzi. Model może popełniać błędy w założeniach, źle interpretować dane albo tworzyć przekonujące, ale niepoprawne uzasadnienie. Wysoki wysiłek rozumowania nie znosi tych ograniczeń.
Czy model ujawnia cały swój tok myślenia?
Fakty — mamy źródła.Nie należy zakładać, że widoczny tekst „rozumowania” jest pełnym i wiernym zapisem procesu wewnętrznego. Systemy mogą udostępniać streszczenia albo wybrane informacje, a część obliczeń pozostaje niewidoczna. Różnice implementacyjne między dostawcami utrudniają bezpośrednie porównywanie takich zapisów.Źródła ↓
Archiwalny artykuł Grzegorza Łukasika (2025) (otwiera się w nowej karcie) wprowadzał pojęcie modeli rozumujących. Nowe opracowanie akcentuje przede wszystkim kryteria ich praktycznego wyboru i niezależnej weryfikacji wyników.Źródło: Archiwum — Grzegorz Łukasik
Krótka karta decyzji dla czytelnika
Wnioski redakcji.Jeśli zadanie jest proste i łatwe do sprawdzenia, zacznij od szybkiego trybu. Jeśli obejmuje wiele kroków i ograniczeń, wypróbuj model rozumujący. Jeśli pomyłka może mieć poważne konsekwencje, wymagaj niezależnego sprawdzenia niezależnie od użytego trybu.
Przy porównywaniu modeli stosuj jeden zestaw zadań, podobne limity czasu i kosztów, oceniaj poprawność końcowych wyników, nie samą płynność wyjaśnień. Ten schemat nadaje się także do pracy z uczniami i audytów jakości odpowiedzi AI.
Źródła i dalsza lektura
- 1.Reasoning models — OpenAI API OpenAI Developers
- 2.Gemini thinking — Gemini API Google AI for Developers
- 3.Reasoning best practices OpenAI Developers
- 4.Czym są modele rozumujące i jak z nich korzystać? (2025) ZroZoom AI / Blogger
Powiązane materiały
Jak działają duże modele językowe i multimodalne
Tokeny, okno kontekstu, trening i dostrajanie. Wyjaśniamy, co dzieje się między Twoim pytaniem a odpowiedzią modelu oraz dlaczego probabilistyczna natura architektury rodzi halucynacje.
Promptowanie i weryfikacja wyników: metoda pięciu kroków
Dobry prompt to jasny cel, kontekst, format i kryteria jakości. Omawiamy profesjonalną inżynierię poleceń, oficjalne wytyczne twórców modeli oraz procedurę audytu odpowiedzi według ramy NIST.
Programowanie z asystentem AI: przegląd, testy, odpowiedzialność
Asystent kodu potrafi przyspieszyć pisanie funkcji, ale nie przejmuje odpowiedzialności za bezpieczeństwo ani architekturę. Zasada „rozumiem, zanim zatwierdzę”, audyt zależności i testy jednostkowe.